Bionic(原 BionicGPT) 能帮你完成什么工作
下面是根据工具能力整理的操作建议,输入、交付标准和人工核对由你确定。
场景 01 · 有部署能力的企业知识团队内部制度问答
- 先准备
- 获准接入的制度文件、模型端点
- 怎么做
- 编辑建议:先限定一个资料集和用户组,以可核对的问题检查检索结果。
- 得到什么
- 带业务背景的答复草稿
- 使用建议
- 核对原文、访问权限与过期制度。
场景 02 · 企业分析与平台团队基于数据集生成报告
- 先准备
- 脱敏数据表、报告模板与输出要求
- 怎么做
- 编辑建议:通过数据集和沙盒执行分析,把生成文件交给负责人复核。
- 得到什么
- 可下载的报告或表格产物
- 使用建议
- 核对总计、字段含义和异常记录。
场景 03 · 内部 AI 工程师封装重复内部流程
- 先准备
- 批准的系统接口、操作说明和模板
- 怎么做
- 编辑建议:把流程整理为 Skills,先用有限数据和权限验证。
- 得到什么
- 可复用的组织任务流程
- 使用建议
- 检查每个工具调用及结果是否符合权限和业务规则。
Bionic(原 BionicGPT) 软件界面
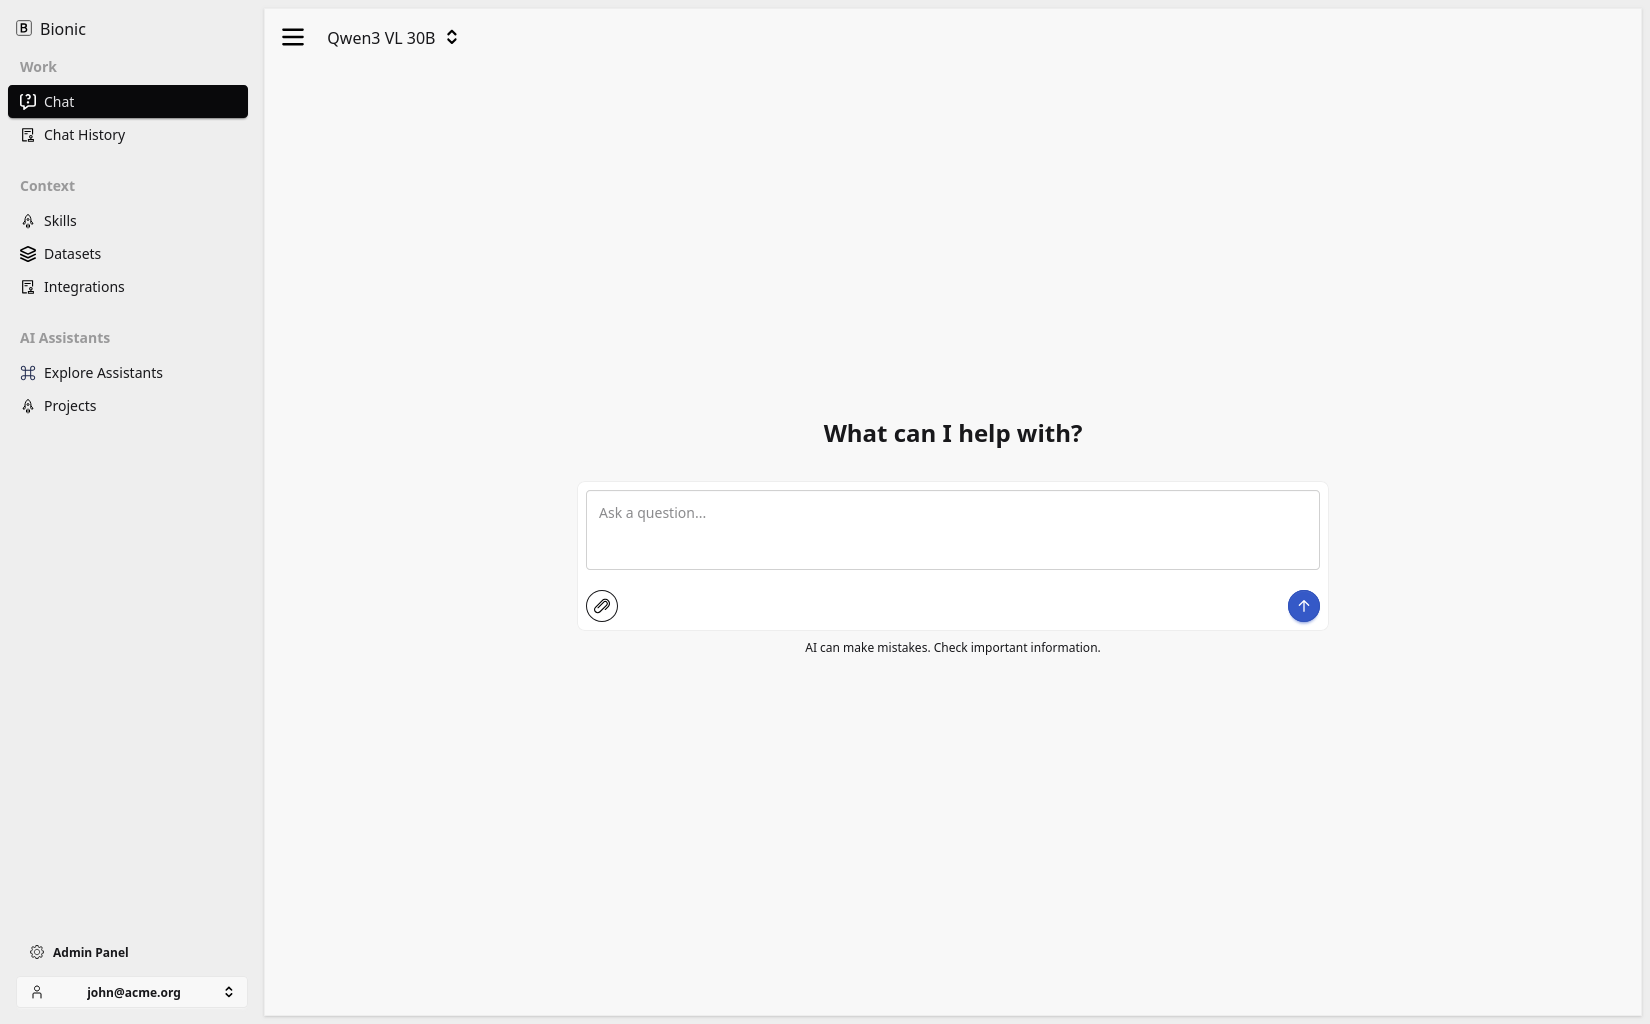
BionicGPT 官方项目展示的聊天工作区,左侧包含数据集、集成、助手和项目入口,上方选择模型。
Bionic(原 BionicGPT) 是什么
现行官方项目强调可控的企业运行平台:对话只是入口,模型还可检索数据、调用工具并生成文件。它适合有部署和权限管理能力的团队;模型、基础设施与组织流程需要自行选配。
Bionic(原 BionicGPT) 的主要功能
组织对话与文件产物
工作区保存会话,并把上传文件、数据集和生成产物纳入运行环境。适合围绕同一业务材料继续分析,将报告等产物交给人员复核。
连接组织知识与模型
支持基于数据集的 RAG,并可连接托管、私有或本地模型。资料源和模型端点分别配置,检索范围应对应使用者的业务权限。
通过沙盒与虚拟文件系统执行任务
代理以 run_bash 工具使用受控能力,虚拟文件系统呈现附件、记忆、Skills、数据集与产物。运行环境把可用资源组织起来,不需要把全部文件塞进提示词。
以团队与审计控制使用
项目包含 SSO/OIDC、团队权限、审计与用量控制。平台管理员应把身份和模型、数据、集成的授权组合起来,而不是只建立一个共享聊天入口。
如何开始使用 Bionic(原 BionicGPT)
选择部署路线
官方将 Docker Compose 用于本地评估和小型试点,将 Kubernetes 用于更接近生产的测试与部署。先按团队环境选择路线并阅读对应安装文档。
准备模型与存储资源
配置批准的模型端点、数据库和文档或产物存储,确认请求实际由本地、私有还是外部模型处理。
接入一个受控工作流
建立团队权限,添加必要数据集、集成与 Skills;从一个明确的问答或文件产出任务开始。
检查审计与业务输出
用不同权限账号检查可见资料和工具边界,复核生成文件,再决定是否扩大资料和集成范围。
费用与使用条件
选择前了解
模型、运维与授权由团队管理
自托管需要持续运维
代码可自行部署,但身份、存储、模型连接、更新和故障处理仍由部署团队承担,不能把开源当作免维护的云账号。
模型与外部集成分别受控
项目支持本地、私有和托管模型;是否将材料发送到外部取决于实际模型与集成配置,自托管界面本身不能决定全部数据流。
社区软件与商业支持不同
社区提供开源自托管基础;企业支持、SLA、安全响应和部署协助属于另外的商业服务,不能从源码许可推导已经包含这些服务。
Bionic(原 BionicGPT) 常见问题
BionicGPT 现在叫 Bionic 吗?
官方仓库当前使用 Bionic 名称,并将其描述为企业内部 AI 团队的智能体运行平台。
只是一个本地聊天界面吗?
不只是。现行项目还包括 RAG、沙盒工具执行、Skills、文件产物及团队治理能力。
必须使用某一个模型吗?
不必。项目支持批准的托管模型、私有推理端点和本地模型;具体配置由部署团队选择。
个人可以先试用吗?
可以按官方 Docker Compose 路线做本地评估,但仍需准备模型和运行环境;正式团队部署应进一步配置权限、审计与运维。