Docling 能帮你完成什么工作
下面是根据工具能力整理的操作建议,输入、交付标准和人工核对由你确定。
场景 01 · 搭建检索系统的开发者为知识库准备文档
- 先准备
- 代表性PDF、目标导出格式与检查样本。
- 怎么做
- 编辑建议:先转换少量资料,对照原文检查标题、段落与读取顺序,再将通过的结果送入知识库。
- 得到什么
- 结构明确的检索输入。
- 使用建议
- 重点检查双栏阅读顺序、页眉干扰和重复文字。
查看操作流程示意
场景 02 · 需要分析资料的数据人员提取报告里的表格
- 先准备
- 含表格的报告和关键单元格样本。
- 怎么做
- 编辑建议:选择合适解析方式,导出结构化结果后抽查表头、合并单元格和单位。
- 得到什么
- 可继续处理的表格结构。
- 使用建议
- 不因生成了表格就假设数据完整,关键数字逐项回看。
场景 03 · 管理历史扫描资料的人转换扫描档案
- 先准备
- 清晰扫描件及期望输出。
- 怎么做
- 编辑建议:使用OCR或相应视觉管线处理少量页面,再调整设置并分批转换。
- 得到什么
- 可搜索的文本或结构化文档。
- 使用建议
- 检查漏页、旋转、识别错误及模型对目标语言的支持。
Docling 软件界面
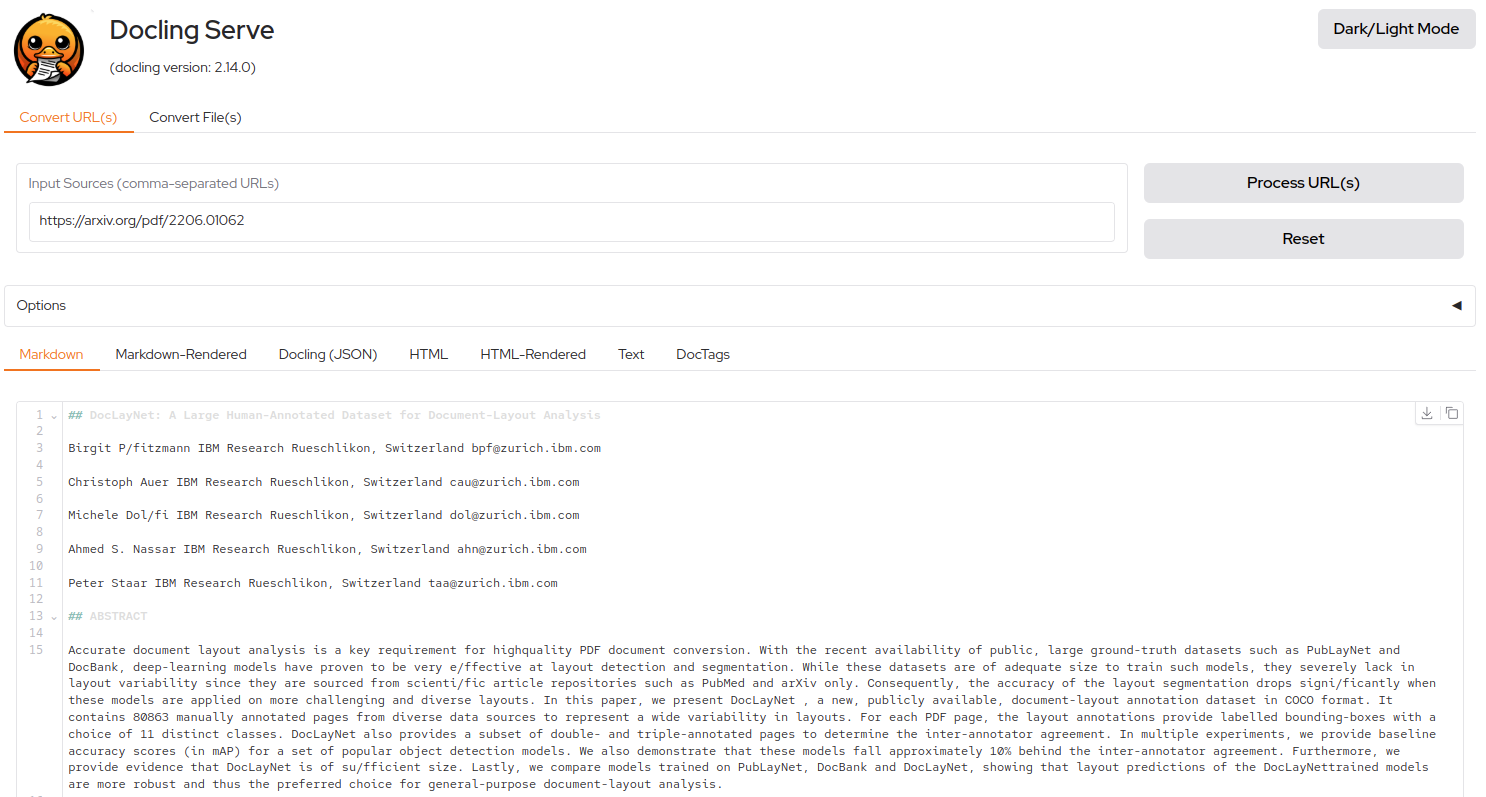
官方 Docling Serve 示例界面展示从文档 URL 转换到 Markdown,并提供 JSON、HTML、文本等输出页签;画面标注 Docling 2.14.0。
Docling 是什么
它关注读取顺序、表格和结构,而不是仅把页面当成一段文字;扫描件还可使用OCR或视觉模型处理。
解析工具、所选模型与下游问答是不同环节。先检查转换结果,再把资料交给检索或生成系统。
Docling 的主要功能
解析多种文档格式
支持PDF、DOCX、PPTX、XLSX、HTML及多种图片等输入,统一交给文档处理流程。
识别PDF版面结构
解析页面布局、读取顺序、表格、代码与公式等元素,帮助保留内容的结构关系。
对扫描资料执行OCR
可使用OCR与视觉语言模型处理扫描PDF或图片,具体能力取决于选定的处理管线和模型。
导出并接入AI系统
DoclingDocument可导出Markdown、HTML及无损JSON等;还提供CLI、API服务及MCP接入方式。
如何开始使用 Docling
准备合适的Python环境
当前版本使用Python 3.10或更新版本,按官方说明安装docling。
选择代表性输入
先选一份具有真实版式的文档,确认本地路径或可访问URL和输出目标。
运行CLI或Python转换
使用docling命令或DocumentConverter执行转换,按需要选择默认或视觉模型管线。
检查结构再导出接入
回看读取顺序、表格和OCR结果,合格后再导出Markdown或JSON并接入后续流程。
费用与使用条件
选择前了解
- 使用方式
- 命令行 / API / 私有部署
当前安装要求Python 3.10及以上;代码为MIT许可,各模型仍按原始模型许可使用。
Python版本要求已提高
官方安装说明写明2.70.0起不再支持Python 3.9,现行安装应使用Python 3.10或更新版本。
不同管线依赖不同模型
OCR、视觉和音频等能力由相应模型或组件提供,环境与资源需求不能按最简单文本转换推断。
代码与模型授权分开
Docling代码使用MIT许可,官方明确要求各模型按原包的许可处理;文档内容也需有合法使用权。
Docling 常见问题
Docling会直接回答文档问题吗?
核心职责是解析和导出文档,为问答或检索系统准备输入;完整问答通常需要下游模型和应用。
可以处理扫描PDF吗?
支持OCR及视觉模型管线。先检查扫描清晰度和目标语言,再抽查转换结果。
能保留表格和阅读顺序吗?
它专门处理这些结构,但复杂版式仍需要对照原文,不能保证每份文档都无误。
MIT许可适用于所有模型吗?
不适用。官方明确区分代码许可与各模型的原始许可,使用模型时需分别查看。