GPT Researcher 能帮你完成什么工作
下面是根据工具能力整理的操作建议,输入、交付标准和人工核对由你确定。
场景 01 · 需要快速建立背景的分析者制作主题研究初稿
- 先准备
- 明确问题、时间范围、允许来源和输出结构。
- 怎么做
- 编辑建议:设置模型及检索服务,先用窄问题运行研究,再逐个检查引用与相反证据。
- 得到什么
- 可修改的研究报告初稿。
- 使用建议
- 核对来源日期、真实可访问性及结论是否超出资料。
查看操作流程示意
场景 02 · 有一组项目文件的人汇总本地项目资料
- 先准备
- 允许处理的本地文档及问题清单。
- 怎么做
- 编辑建议:设置DOC_PATH并选择本地报告来源,要求围绕文件中的事实整理。
- 得到什么
- 针对资料集的研究摘要。
- 使用建议
- 确认实际选用local来源;云模型配置仍可能发送内容到外部服务。
场景 03 · 能够配置MCP的技术人员研究指定技术仓库
- 先准备
- 仓库范围、只读数据源和研究目标。
- 怎么做
- 编辑建议:通过MCP提供受限资料入口,先检查返回内容,再将其用于研究报告。
- 得到什么
- 带仓库线索的技术调查。
- 使用建议
- 检查连接权限与引用版本,避免让报告混用不同提交的事实。
GPT Researcher 软件界面
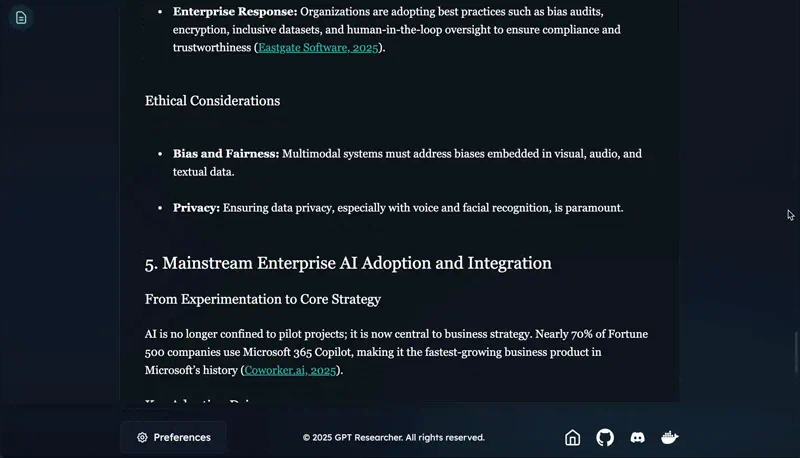
官方演示界面:研究报告按章节展示正文与引用链接,底部可打开参考资料入口。
GPT Researcher 是什么
流程包含规划、抓取、来源摘要及报告汇总,也可通过MCP接入其他资料源。报告仍是需要核对的研究初稿。
搜索、语言模型和可选图片生成有各自的凭证与调用条件;本地资料研究也不自动意味着模型在本机运行。
GPT Researcher 的主要功能
把任务拆成研究问题
规划与执行流程会围绕任务生成问题,再分支收集并汇总材料,适合有明确边界的研究。
使用网络或本地文档
可选择网络研究,也可设置DOC_PATH从PDF、文本、表格、演示文稿等本地资料开展研究。
生成有来源的报告
流程追踪资源并整合摘要,支持导出PDF、Word等格式,便于后续阅读与人工修改。
扩展研究资料入口
MCP可以连接仓库、数据库及自定义API等来源;递归研究的深度与广度也可以配置。
如何开始使用 GPT Researcher
准备运行环境和服务
按当前安装说明使用Python 3.12或更新版本,并配置所用模型与检索凭证。
确定报告来源
网络研究选择相应检索来源;本地研究设置DOC_PATH并选择local或My Documents。
限定研究任务
给出问题、范围、禁止扩展的主题和报告结构,再开始研究。
检查引用并导出
核对重要来源和遗漏后,再导出所需格式;编辑建议:保留人工修订与原始报告的区别。
费用与使用条件
选择前了解
- 使用方式
- 网页 / API / 私有部署
本地文档研究需设置DOC_PATH并选择local来源;模型与检索服务仍按实际端点配置。
服务费用不是固定报告价
所用模型、搜索、MCP及图片生成均有各自条件;官方示例耗时和成本不能作为当前每次任务的保证。
本地文件不等于离线研究
local表示报告资料来源,模型是否联网由模型端点决定,需要分别确认数据流。
增加深度也会增加工作量
递归研究可调深度和广度,更多分支意味着更多收集与处理;先用小范围任务检查质量再扩大。
GPT Researcher 常见问题
可以只研究本地文件吗?
可以,配置DOC_PATH并选择本地报告来源;但还应检查模型端点是否为本地。
报告引用能直接用于正式结论吗?
应先打开来源核对内容、时间和上下文。自动报告提供研究线索,不代替人工判断。
必须通过网页使用吗?
不必。项目提供Python包,也有网页前端和Docker运行方式,可按集成需求选择。
不开图片生成还能研究吗?
可以。图片生成是可选能力,需要独立模型配置与凭证,资料研究流程不必依赖它。