Piper 能帮你完成什么工作
下面是根据工具能力整理的操作建议,输入、交付标准和人工核对由你确定。
场景 01 · 有本地工具经验的使用者制作一段文本朗读
- 先准备
- 有权使用的文章节选与目标语言。
- 怎么做
- 编辑建议:先选声线和许可,合成人名、数字较多的短段,再调整标点与停顿。
- 得到什么
- 可继续检查的朗读音频。
- 使用建议
- 逐句确认读音、漏词、音量和使用范围。
查看操作流程示意
场景 02 · 应用开发者设计应用语音提示
- 先准备
- 简短提示文案和目标设备。
- 怎么做
- 编辑建议:选择适合语言的模型,用同一组词句验证,调整句间静音和音量。
- 得到什么
- 风格较一致的语音提示候选。
- 使用建议
- 检查专有名词、提示长度及模型许可,不冒用他人声音。
场景 03 · 有部署经验的人员运行重复播报服务
- 先准备
- 多次合成需求、声线模型与接口规则。
- 怎么做
- 编辑建议:单句验证后评估服务接口,减少重复加载,并安排访问和资源控制。
- 得到什么
- 可接入后续应用的合成服务。
- 使用建议
- 测量目标设备表现,核对数据与权限,避免直接暴露未配置的服务。
Piper 软件界面
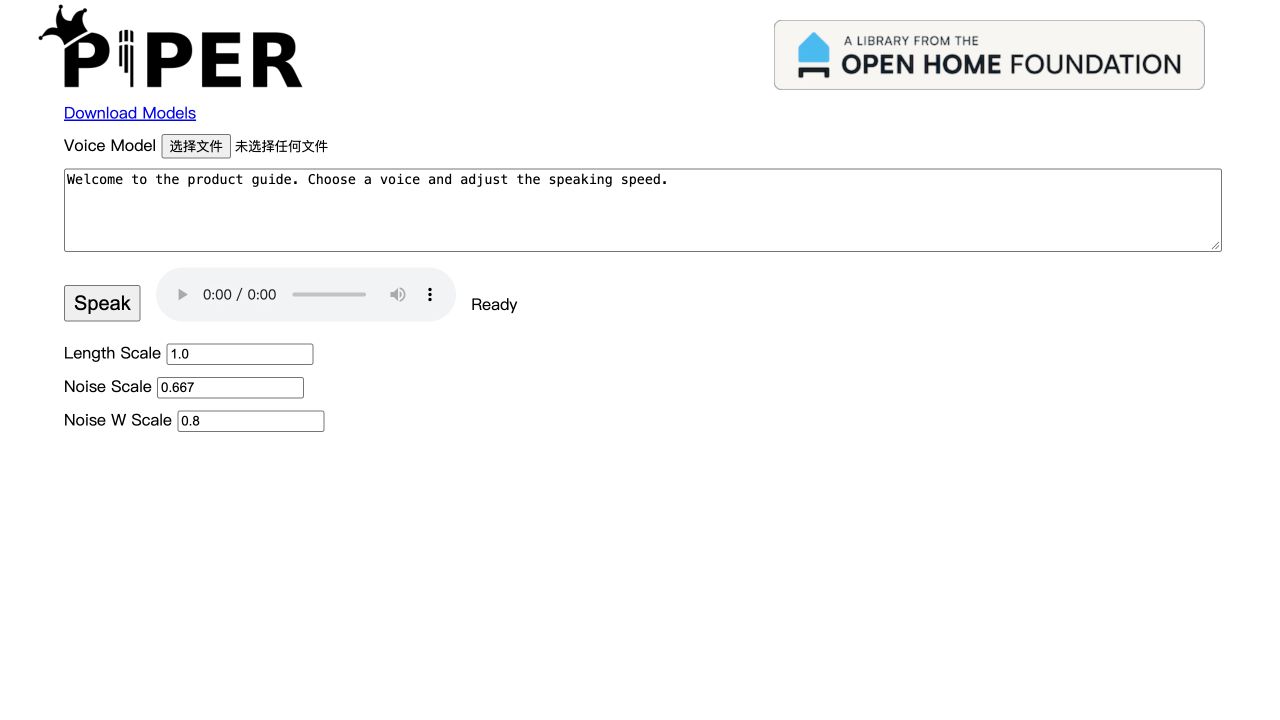
官方浏览器演示的模型导入、文字输入与语音参数设置。
Piper 是什么
开始前先选择目标语言与声音模型,并同时准备模型和配置文件。短句测试应包含人名、数字和标点,再决定是否用于长文本或重复服务。
引擎代码与每款声音模型的许可要分别查看。官方提示部分声线可能有受限许可;仓库开源和声线可下载不能直接等同于任意商业用途。
Piper 的主要功能
选择语言和声音模型
官方声线库覆盖多种语言,包括简体中文;每个声音需要配套的模型及配置文件,并应先听样本。
将文字合成为本地音频
命令行可从文字或文本文件生成音频文件,也可在具备相应播放工具时直接播放,适合受控朗读流程。
调整语音间隔和音量
提供句间静音、音量倍数和自动归一化等选项,适合根据用途调整输出;复杂发音也可按官方音素方式处理。
在应用中重复调用
提供Web服务、Python与C/C++接口等路线;官方建议反复调用时使用服务,避免命令行每次重新载入模型。
如何开始使用 Piper
选择语言和声线
试听模型样本,阅读对应MODEL_CARD中的使用条件,确认与项目用途匹配。
准备配套模型与配置
确认模型及配置文件齐全并与当前引擎兼容,再建立本地运行路线。
合成短句并调整
先处理人名、数字和标点,按需要调整句间静音、音量或发音表达。
检查输出再接入应用
回听确认可懂度和许可,再选择文件输出、重复服务或程序接口,并核对运行资源。
费用与使用条件
选择前了解
- 中文支持
- 支持
- 使用方式
- 命令行 / API / 私有部署
本地语音引擎与声音模型的许可分开,逐模型检查 MODEL_CARD;提供简体中文声音,硬件与运行成本由使用者承担。
每款声音有独立许可
官方要求查看各声线MODEL_CARD,并提醒部分模型有受限许可;不能用引擎开源证明全部声音都可商用。
模型与配置必须匹配
一个声音需要模型和对应配置,语言与声线选择也影响读音,不宜混用不匹配文件。
重复启动会增加加载开销
官方说明命令行每次需要载入模型,反复调用宜评估服务路线;GPU选项还需要相应运行包和硬件。
Piper 常见问题
Piper自带所有声音吗?
需要另行选择并准备声音模型及配套配置,先试听并阅读该模型的说明。
可以生成中文语音吗?
官方声音列表包含简体中文模型;具体音色、读音与许可仍以所选模型为准。
所有声音都能免费商用吗?
不能这样推断。官方明确提醒部分声线许可受限,需分别查看代码许可和对应MODEL_CARD。
为什么每次合成短句都要等待加载?
命令行调用通常每次重新载入模型。官方建议重复使用时考虑Web服务,但仍需自己配置和检查运行环境。